WordPress Daten automatisch importieren: Methoden, Plugins und sichere Praxis
WordPress Daten automatisch importieren zu lassen, spart Zeit und reduziert manuelle Übertragungsfehler. Ob Produkte aus einem Warenwirtschaftssystem, Beiträge aus einer externen Datenquelle oder Kundendaten aus einer Schnittstelle übernommen werden sollen: Entscheidend ist nicht nur der Import selbst, sondern ein sauberer Ablauf mit klarer Datenstruktur, Fehlerbehandlung und regelmäßiger Kontrolle.
Passende WordPress Hilfe zum Thema
Was bedeutet „WordPress Daten automatisch importieren“?
Beim automatischen Import werden Informationen aus einer Quelle regelmäßig oder ereignisbezogen nach WordPress übertragen. Die Quelle kann beispielsweise eine CSV-Datei, eine XML-Datei, eine externe Datenbank, eine REST-API oder ein anderes System sein. WordPress übernimmt die Daten dann in Beiträge, Seiten, individuelle Inhaltstypen, Medien, Benutzerprofile oder WooCommerce-Produkte.
Ein einmaliger Import und eine laufende Synchronisation sind dabei zwei unterschiedliche Aufgaben. Ein einmaliger Import eignet sich etwa für eine Migration. Eine Synchronisation muss zusätzlich erkennen, welche Datensätze neu, geändert oder gelöscht wurden. Dafür benötigt jeder Datensatz eine stabile Zuordnung, zum Beispiel eine externe ID oder eine eindeutige Artikelnummer.
Der Begriff „automatisch“ kann ebenfalls verschiedene Bedeutungen haben. Ein geplanter Cronjob importiert Daten zu bestimmten Zeitpunkten. Ein Webhook startet den Import unmittelbar nach einer Änderung im Quellsystem. Bei einer API-Abfrage ruft WordPress die Daten selbstständig ab. Welche Variante sinnvoll ist, hängt von Aktualität, Datenmenge, Sicherheit und den Möglichkeiten der Quelle ab.
Welche Daten lassen sich in WordPress importieren?
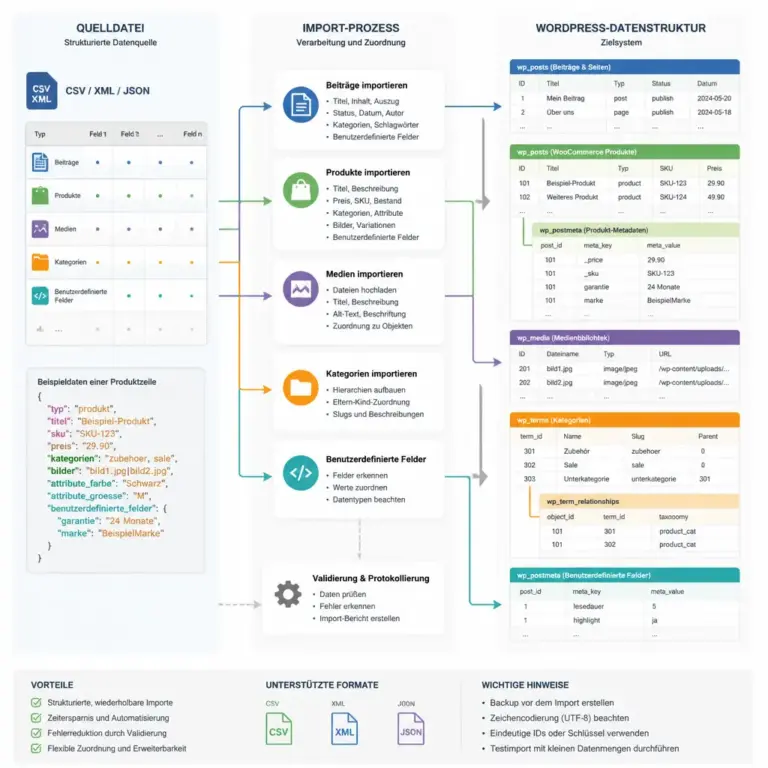
Die Darstellung macht sichtbar, dass ein Import aus mehreren Datentypen besteht und jedes Feld einem passenden WordPress-Ziel zugeordnet werden muss. Das hilft dir, die Datenstruktur vor der technischen Einrichtung zu planen.
Grundsätzlich können sehr unterschiedliche Daten in WordPress verarbeitet werden. Wichtig ist, dass die Zielstruktur vor dem ersten Import festgelegt wird. Ein Importer kann Daten nicht zuverlässig zuordnen, wenn beispielsweise unklar ist, ob ein Feld eine Kurzbeschreibung, ein Preis, ein Datum oder ein interner Hinweis sein soll.
- Beiträge und Seiten: Titel, Inhalt, Auszug, Status, Kategorien, Schlagwörter und Veröffentlichungsdaten.
- Individuelle Inhaltstypen: Immobilien, Veranstaltungen, Stellenanzeigen, Referenzen oder Verzeichniseinträge.
- WooCommerce-Produkte: Name, Beschreibung, SKU, Preis, Bestand, Kategorien, Attribute und Produktbilder.
- Medien: Bilddateien, Dokumente, Dateinamen, Alternativtexte und Zuordnungen zu Inhalten.
- Benutzerbezogene Daten: Nur wenn die rechtliche Grundlage, die Zugriffskontrolle und die Datenqualität geklärt sind.
- Taxonomien: Kategorien, Schlagwörter oder individuelle Gruppierungen.
Nicht jede Information sollte direkt in den Inhalt geschrieben werden. Technische IDs, Filterwerte und strukturierte Eigenschaften gehören häufig in benutzerdefinierte Felder. So bleiben Inhalte lesbar und können im Theme oder in Abfragen gezielt verwendet werden.
Die wichtigsten Importquellen
CSV- und XML-Dateien
CSV-Dateien sind weit verbreitet und für tabellarische Daten praktisch. Vor dem Import müssen Trennzeichen, Zeichencodierung, Spaltennamen und Zeilenumbrüche eindeutig sein. Eine Datei kann in einem Tabellenprogramm korrekt aussehen, aber beim Import dennoch Probleme verursachen, wenn beispielsweise Semikolons und Kommas verwechselt werden oder Sonderzeichen nicht als UTF-8 vorliegen.
XML-Dateien bilden oft verschachtelte Strukturen ab. Das ist hilfreich, wenn ein Produkt mehrere Bilder, Varianten oder Eigenschaften besitzt. Dafür ist die Zuordnung komplexer als bei einer einfachen Tabelle. Der Importer muss die XML-Struktur kennen und darf nicht nur nach gleichlautenden Feldnamen suchen.
REST-APIs
Eine REST-API stellt Daten meist über HTTP-Endpunkte bereit. WordPress kann solche Endpunkte mit PHP, einem spezialisierten Plugin oder einer individuellen Integration ansprechen. Typische Aspekte sind Authentifizierung, Seitennummerierung, Antwortformate, Zeitüberschreitungen und begrenzte Anfragehäufigkeiten.
Ein stabiler Import liest nicht zwangsläufig alle Datensätze bei jedem Lauf erneut ein. Besser ist häufig ein inkrementeller Abruf, bei dem nur seit einer bestimmten Zeit geänderte Datensätze verarbeitet werden. Ob das möglich ist, hängt von der API ab. Unterstützt sie keine Änderungszeitpunkte, kann eine externe ID mit einem Hash des relevanten Inhalts verglichen werden.
Externe Datenbanken
Eine direkte Verbindung zu einer externen MySQL- oder MariaDB-Datenbank kann technisch möglich sein, ist aber besonders sorgfältig abzusichern. WordPress sollte nicht mit weitreichenden Datenbankrechten auf ein fremdes System zugreifen. Besser ist ein begrenzter Benutzer mit lesendem Zugriff oder eine kontrollierte API-Schicht. Datenbanktabellen, Zeichensätze und Feldtypen müssen ebenfalls zusammenpassen.
Webhooks und Ereignisse
Bei einem Webhook sendet das Quellsystem eine Nachricht, sobald ein Datensatz geändert wurde. Dadurch können Aktualisierungen zeitnah verarbeitet werden. Der Endpunkt muss jedoch geschützt sein. Eine Signatur, ein geheimer Schlüssel, eine erlaubte Anfragequelle oder eine zusätzliche Authentifizierung können helfen, unberechtigte Aufrufe zu verhindern. Außerdem sollte die Verarbeitung idempotent sein: Derselbe Webhook darf nicht bei jedem erneuten Zustellversuch einen doppelten Datensatz anlegen.
Import mit Plugin oder individueller Entwicklung?
Für einfache und gut strukturierte Daten kann ein Import-Plugin ausreichen. Plugins bieten oft Zuordnungen zwischen Quelldaten und WordPress-Feldern, Zeitpläne, Wiederholungen und Protokolle. Sie sind besonders praktisch, wenn der Import einmalig oder in einem überschaubaren Rhythmus durchgeführt wird.
Eine individuelle Lösung ist sinnvoll, wenn mehrere Systeme beteiligt sind, komplexe Regeln gelten oder Daten in Echtzeit beziehungsweise nahezu in Echtzeit verarbeitet werden sollen. Auch spezielle Anforderungen an Produktvarianten, Bilder, Beziehungen zwischen Inhaltstypen oder Fehlerbehandlung sprechen für eine maßgeschneiderte Integration.
| Variante | Geeignet für | Zu beachten |
|---|---|---|
| Import-Plugin | Strukturierte CSV-, XML- oder API-Daten mit überschaubaren Regeln | Funktionsumfang, Wartbarkeit und Kompatibilität mit Theme und Plugins prüfen |
| Individuelles Plugin | Komplexe Zuordnungen, eigene Geschäftslogik und wiederkehrende Synchronisation | Saubere Programmierung, Logging, Tests und Updatefähigkeit einplanen |
| Middleware | Mehrere Systeme, Transformationen und zentrale Datenflüsse | Zusätzliche Komponente, deren Betrieb und Überwachung berücksichtigt werden müssen |
| Direkter Datenbankzugriff | Spezielle technische Szenarien mit kontrollierter Infrastruktur | Hohe Anforderungen an Rechte, Sicherheit, Datenkonsistenz und Wartung |
Ein Import-Plugin ist nicht automatisch die beste Lösung, nur weil es schnell eingerichtet werden kann. Prüfe, ob die Datenquelle dauerhaft unterstützt wird, ob ein Update des Plugins zu Änderungen führen kann und ob der Import nachvollziehbare Protokolle erzeugt. Bei geschäftskritischen Daten sollte die Entscheidung nicht allein nach dem Umfang der Einstellungsoberfläche getroffen werden.
Datenmodell und Feldzuordnung zuerst planen
Der häufigste Grund für unzuverlässige Importe ist nicht der technische Abruf, sondern eine unklare Zuordnung. Erstelle deshalb vorab eine Übersicht mit Quellfeld, Zielfeld, Datentyp, Pflichtstatus und Umwandlungsregel.
| Quellfeld | WordPress-Ziel | Regel |
|---|---|---|
| external_id | Benutzerdefiniertes Feld | Als stabile externe Referenz speichern |
| name | Titel | Leere Werte ablehnen oder gesondert protokollieren |
| description | Inhalt | HTML erlauben, bereinigen oder in Klartext umwandeln |
| category_code | Taxonomie | Code zunächst einer vorhandenen oder neu anzulegenden Gruppe zuordnen |
| updated_at | Benutzerdefiniertes Feld | Zeitzone und Datumsformat eindeutig behandeln |
Verwende für die Synchronisation möglichst eine externe ID. Der WordPress-interne Beitragsschlüssel kann sich in einer anderen Umgebung unterscheiden und sollte nicht als alleinige Verbindung zum Quellsystem dienen. Bei Produkten ist die SKU oft geeignet, sofern sie tatsächlich eindeutig und dauerhaft unverändert bleibt.
Schritt für Schritt: WordPress Daten automatisch importieren
1. Quelle und Ziel definieren
Beschreibe zuerst, welches System die führende Quelle ist. Wenn ein Produkt im ERP-System gepflegt wird, sollte WordPress nicht gleichzeitig eigene Werte ohne klare Regel überschreiben. Lege außerdem fest, welche Daten nur importiert, welche aktualisiert und welche aus WordPress entfernt werden dürfen.
2. Testumgebung und Backup einrichten
Führe den ersten Import nicht direkt auf der produktiven Website durch. Ein aktuelles Backup ist wichtig, ersetzt aber keine Testumgebung. Auf einem Staging-System kannst du Feldzuordnungen, Bildimporte, Taxonomien und Updates prüfen, ohne den laufenden Betrieb zu gefährden.
Beachte, dass Datenbank- und Dateibackups unterschiedliche Bereiche abdecken. Inhalte und Einstellungen liegen überwiegend in der Datenbank, während Medien in der Upload-Struktur gespeichert werden. Ein vollständiger Wiederherstellungstest zeigt, ob die Sicherung im Ernstfall tatsächlich brauchbar ist.
3. Kleinen Testdatensatz verwenden
Importiere zunächst eine überschaubare Auswahl mit normalen, leeren und ungewöhnlichen Werten. Dazu gehören lange Texte, Umlaute, Sonderzeichen, fehlende Bilder, doppelte Kategorien und Datumsangaben in verschiedenen Formaten. Ein kleiner Test macht Fehler schneller sichtbar als ein kompletter Lauf mit vielen Datensätzen.
4. Feldmapping und Transformation konfigurieren
Ordne jedes Quellfeld einem klaren Ziel zu. Preise müssen beispielsweise einheitlich als Zahlen verarbeitet werden, während Datumswerte in eine definierte Zeitzone umgewandelt werden sollten. Bei HTML-Inhalten ist zu prüfen, welche Tags erlaubt sind. Eingehende Inhalte dürfen nicht ungeprüft als vertrauenswürdig behandelt werden.
5. Aktualisieren statt Duplizieren
Der Import muss bestehende Datensätze wiederfinden. Dafür wird die externe ID ausgelesen und mit dem gespeicherten Wert verglichen. Wird kein Treffer gefunden, kann ein neuer Datensatz angelegt werden. Wird ein Treffer gefunden, wird der vorhandene Datensatz aktualisiert. Ohne diese Logik entstehen bei jedem Lauf neue Beiträge oder Produkte.
6. Medien kontrolliert übernehmen
Bildimporte benötigen zusätzliche Regeln. Prüfe Dateityp, Dateigröße, Dateinamen und Erreichbarkeit der Bildquelle. Speichere importierte Dateien nicht mehrfach, wenn sich nur die Zuordnung ändert. Für Bilder sollten außerdem Alternativtexte aus einer geeigneten Quelle übernommen oder nach einem nachvollziehbaren Muster erzeugt werden.
7. Zeitplan oder Ereignisverarbeitung aktivieren
Ein geplanter Import kann über einen Server-Cronjob oder den WordPress-Cronmechanismus gestartet werden. Der WordPress-Cronmechanismus arbeitet typischerweise bei Seitenaufrufen und ist deshalb bei wenig besuchten Websites nicht immer exakt zeitgesteuert. Für planbare Abläufe ist ein serverseitiger Cronjob oft besser geeignet, sofern der Hostingzugang das erlaubt.
Bei Webhooks sollte die Anfrage zunächst validiert und möglichst in eine Warteschlange übergeben werden. Die eigentliche Verarbeitung kann dann kontrolliert erfolgen. Das verhindert, dass eine externe Anfrage wegen eines langen Imports in einen Timeout läuft.
8. Ergebnis prüfen und protokollieren
Ein guter Import zeigt nicht nur Erfolg oder Fehler an. Er protokolliert auch, wie viele Datensätze neu angelegt, aktualisiert, übersprungen oder abgelehnt wurden. Fehlermeldungen sollten die externe ID und den betroffenen Feldnamen nennen, aber keine geheimen Zugangsdaten in Logdateien schreiben.
Typische Fehler beim automatischen Import
Doppelte Beiträge oder Produkte
Duplikate entstehen meist, wenn keine stabile externe Kennung gespeichert wird oder wenn sich das Format der Kennung zwischen zwei Läufen verändert. Lösung: eine eindeutige Referenz definieren, vor dem Anlegen nach ihr suchen und Änderungen an der Zuordnungslogik in einer Testumgebung prüfen.
Falsche Zeichencodierung
Fehlende Umlaute oder unlesbare Sonderzeichen weisen häufig auf eine nicht passende Zeichencodierung hin. Die Quelle, der Importer, die Datenbank und die Ausgabe sollten konsistent arbeiten. Eine nachträgliche Reparatur beschädigter Inhalte ist aufwendiger als eine korrekte Konfiguration vor dem ersten produktiven Lauf.
Unvollständige oder veraltete Daten
Ein Import kann erfolgreich durchlaufen und trotzdem fachlich falsche Ergebnisse liefern. Beispielsweise liefert die API nur die erste Seite ihrer Ergebnisse oder ein Filter berücksichtigt nicht alle Statuswerte. Prüfe daher Seitennummerierung, Abrufgrenzen, Änderungszeitpunkte und die Anzahl der erwarteten Datensätze.
Zu viele Anfragen an die API
Wer jeden Datensatz einzeln und ohne Pause abruft, kann Begrenzungen der Quelle auslösen. Nutze, sofern vorhanden, Sammelabfragen, Änderungsfilter und angemessene Pausen. Bei temporären Fehlern helfen kontrollierte Wiederholungen mit wachsendem Abstand. Dauerhafte Fehler sollten nicht endlos wiederholt werden.
Import läuft in ein Timeout
Große Datenmengen sollten in kleinere Pakete aufgeteilt werden. Ein Import kann nach jedem Paket den Fortschritt speichern und später fortsetzen. So muss ein Abbruch nicht den gesamten Lauf von vorne beginnen. Serverlimits wie maximale Laufzeit, Speichergrenze und erlaubte Dateigröße müssen bei der Planung berücksichtigt werden.
Gelöschte Quelldaten bleiben in WordPress
Eine Synchronisation muss ausdrücklich definieren, was bei einer Löschung passiert. Das Löschen in WordPress kann riskant sein, besonders wenn redaktionelle Änderungen oder Verknüpfungen bestehen. Eine Alternative ist, den Datensatz auf Entwurf oder inaktiv zu setzen und die Entscheidung zunächst zu protokollieren. Automatisches Löschen sollte nur mit klarer Regel und Wiederherstellungsmöglichkeit eingesetzt werden.
Manuelle Änderungen werden überschrieben
Wenn Redakteure importierte Inhalte anpassen dürfen, muss festgelegt werden, welche Felder bei jedem Lauf überschrieben werden. Eine mögliche Lösung ist die Trennung in Quellfelder und redaktionelle Felder. Alternativ kann der Import nur leere Felder befüllen oder Änderungen anhand eines Statuses berücksichtigen.
Technische Umsetzung in WordPress
Eine individuelle Importlösung sollte als eigenes Plugin umgesetzt werden und nicht durch Änderungen an WordPress-Core-Dateien. Für wiederkehrende Abläufe kommen unter anderem eigene Hooks, WordPress-Cron-Events, die HTTP-API und die REST-API infrage. Die konkrete Architektur hängt von der Datenquelle und dem gewünschten Ausführungsmodell ab.
Beim Schreiben von Daten sollten WordPress-Funktionen verwendet werden, die Berechtigungen, Datenbereinigung und Datenbankzugriffe angemessen berücksichtigen. Direkte SQL-Abfragen sind nicht grundsätzlich ausgeschlossen, müssen aber mit vorbereiteten Abfragen, klaren Tabellenkenntnissen und sorgfältiger Prüfung eingesetzt werden. Für Beiträge, Taxonomien und Metadaten sind die vorgesehenen WordPress-Funktionen oft besser wartbar.
Bei WooCommerce müssen zusätzlich Produktarten, Varianten, Lagerbestand, Steuerkonfiguration und gegebenenfalls Beziehungen zwischen Produkten berücksichtigt werden. Ein einfacher Produkttitel-Import reicht nicht aus, wenn Varianten oder Bestandsänderungen zuverlässig synchronisiert werden sollen.
Authentifizierung und Datenschutz
API-Schlüssel, Passwörter und Zugriffstoken gehören nicht in öffentlich sichtbaren Code oder ungeschützte Logdateien. Nutze, soweit möglich, Umgebungsvariablen oder geschützte Konfigurationen und beschränke Berechtigungen auf das notwendige Maß. Zugänge sollten bei Bedarf widerrufen und erneuert werden können.
Bei personenbezogenen Daten müssen Zweck, Rechtsgrundlage, Zugriff, Aufbewahrung und Löschung geprüft werden. Importiere keine Daten, nur weil sie technisch verfügbar sind. Besonders bei Benutzer-, Kunden- oder Kontaktdaten sollte die fachliche und rechtliche Verantwortung vor der Umsetzung geklärt sein.
Logging, Wiederholungen und Warteschlangen
Ein verlässlicher Import braucht einen nachvollziehbaren Status pro Datensatz. Sinnvolle Zustände können beispielsweise „wartend“, „verarbeitet“, „übersprungen“ und „fehlgeschlagen“ sein. Die genaue Gestaltung hängt vom Projekt ab. Wichtig ist, dass ein Fehler nicht unbemerkt bleibt und ein erfolgreicher Datensatz nicht bei jedem Lauf erneut vollständig verarbeitet werden muss.
Wiederholungen sollten nur bei vorübergehenden Fehlern eingesetzt werden. Ein ungültiger Datensatz wird durch zehn weitere Versuche nicht korrekt. Für problematische Fälle ist eine Fehlerliste hilfreich, die nach Korrektur erneut verarbeitet werden kann.
Praxisbeispiel: Produktdaten aus einer externen Quelle
Angenommen, ein Unternehmen pflegt Produktinformationen in einem externen System. WordPress beziehungsweise WooCommerce soll Namen, Beschreibungen, Bilder, Kategorien, Preise und Bestände übernehmen. Zunächst wird eine externe Produkt-ID als Referenz gespeichert. Anschließend wird festgelegt, dass Preise und Bestände aus der Quelle stammen, während redaktionelle Hinweise in WordPress erhalten bleiben.
Der erste Lauf verarbeitet nur wenige Produkte. Dabei werden Zeichencodierung, Produktbilder, Varianten und Kategorien geprüft. Nach erfolgreicher Kontrolle ruft ein geplanter Prozess nur geänderte Produkte ab. Für jedes Produkt wird die externe ID gesucht. Neue Produkte werden angelegt, bestehende aktualisiert. Produkte, die in der Quelle nicht mehr aktiv sind, werden zunächst auf einen definierten inaktiven Status gesetzt statt sofort gelöscht.
Wenn ein Bild nicht erreichbar ist, wird der Produktdatensatz nicht zwangsläufig vollständig verworfen. Der Fehler wird protokolliert und das Produkt kann mit einem bestehenden Bild oder ohne Bild weiterverarbeitet werden. Ob dieses Verhalten fachlich sinnvoll ist, muss das Projekt entscheiden. Wichtig ist, dass die Regel bekannt und überprüfbar ist.
Qualitätssicherung nach dem Import
Nach jedem größeren Import solltest du Stichproben durchführen. Kontrolliere neue, geänderte und problematische Datensätze. Bei Produkten gehören dazu Preise, Bestände, Varianten, Bilder und die Darstellung im Frontend. Bei Beiträgen sind unter anderem interne Links, Kategorien, Veröffentlichungsstatus und Sonderzeichen relevant.
- Stimmen die Anzahl der neuen und geänderten Datensätze mit dem erwarteten Ergebnis überein?
- Wurden externe IDs eindeutig und dauerhaft gespeichert?
- Sind Pflichtfelder vorhanden und sinnvoll befüllt?
- Funktionieren Bilder, Verknüpfungen und Taxonomien?
- Wurden manuelle Inhalte versehentlich überschrieben?
- Gibt es Fehler im Importprotokoll oder in den Serverlogs?
- Bleibt die Website während und nach dem Lauf nutzbar?
Bei SEO-relevanten Inhalten sollte zusätzlich geprüft werden, ob URLs, Meta-Daten, strukturierte Inhalte und interne Verlinkungen korrekt behandelt werden. Ein Import kann technisch erfolgreich sein und trotzdem unerwünschte Änderungen an sichtbaren oder suchmaschinenrelevanten Inhalten erzeugen.
FAQ
Kann ich Daten ohne Programmierkenntnisse automatisch in WordPress importieren?
Bei einfachen CSV- oder XML-Dateien ist ein Import-Plugin häufig ausreichend. Du musst die Datenstruktur trotzdem verstehen und die Zuordnung sorgfältig prüfen. Sobald mehrere Systeme, komplexe Regeln, personenbezogene Daten oder laufende Synchronisationen beteiligt sind, ist technische Unterstützung oft sinnvoll.
Welche Datenquelle eignet sich am besten?
Das hängt vom Anwendungsfall ab. Eine gut dokumentierte REST-API ist für laufende Synchronisationen oft flexibler als regelmäßig manuell bereitgestellte Dateien. CSV- oder XML-Dateien können dagegen sinnvoll sein, wenn die Quelle keine API anbietet oder die Daten in festen Intervallen exportiert werden.
Wie verhindere ich doppelte Datensätze?
Verwende eine stabile, eindeutige externe ID und speichere sie in WordPress. Vor dem Anlegen eines neuen Datensatzes muss der Import nach dieser ID suchen. Zusätzlich sollten Format, Zeichencodierung und Normalisierung der ID konstant bleiben.
Kann WordPress gelöschte Quelldaten automatisch löschen?
Technisch ist das möglich, aber nicht immer empfehlenswert. Vorher muss eindeutig festgestellt werden, ob ein Datensatz wirklich gelöscht wurde oder nur nicht in der aktuellen Antwort enthalten war. Ein inaktiver Status, ein Prüfprotokoll und eine Wiederherstellungsmöglichkeit sind oft vorsichtigere Optionen.
Wie oft sollte ein automatischer Import laufen?
Die passende Frequenz richtet sich nach der Aktualität der Daten und der Belastbarkeit der Quelle. Für selten geänderte Inhalte genügt möglicherweise ein täglicher Lauf. Bestände oder zeitkritische Informationen können häufigere Abrufe benötigen. Vermeide unnötig kurze Intervalle, wenn die Quelle keine Echtzeitverarbeitung erfordert.
Was passiert, wenn die externe API nicht erreichbar ist?
Der Import sollte den Fehler protokollieren, den bisherigen Datenstand nicht unkontrolliert überschreiben und einen späteren Wiederholungsversuch ermöglichen. Eine Benachrichtigung kann sinnvoll sein, damit ein Ausfall nicht erst durch veraltete Inhalte auffällt.
Ist ein Backup vor jedem Import notwendig?
Vor einem ersten, großen oder strukturell verändernden Import ist ein aktuelles Backup besonders wichtig. Bei sehr häufigen kleinen Synchronisationen kann eine geeignete Wiederherstellungsstrategie mit Staging, Datenbank-Sicherungen und protokollierten Änderungen sinnvoller sein als ein vollständig manueller Ablauf vor jedem einzelnen Lauf.
Kann ein automatischer Import auch Bilder und Kategorien übernehmen?
Ja, sofern die Quelle die nötigen Informationen liefert und der Importer diese verarbeitet. Bilder benötigen zusätzliche Prüfungen für Dateityp, Erreichbarkeit und Duplikate. Kategorien müssen eindeutig zugeordnet werden, damit nicht bei jedem Lauf neue, ähnlich benannte Begriffe entstehen.
Fazit
WordPress Daten automatisch zu importieren, ist vor allem eine Aufgabe der sauberen Datenmodellierung und zuverlässigen Synchronisationslogik. Entscheidend sind eine stabile externe Kennung, klare Feldzuordnungen, kontrollierte Verarbeitung und aussagekräftige Protokolle. Beginne mit einem kleinen Test auf Staging, sichere die produktive Website und lege fest, wie Änderungen, Fehler und Löschungen behandelt werden.
Für einfache Dateien kann ein passendes Import-Plugin genügen. Bei APIs, WooCommerce, mehreren Datenquellen oder komplexen Geschäftsregeln ist eine individuelle, updatefähige Lösung oft besser kontrollierbar. So wird aus einem einmaligen Datenabgleich ein belastbarer Prozess, der im Alltag nachvollziehbar und wartbar bleibt.